Tips Menjalankan LLM Offline Lebih Efisien, Dari Quantization hingga Pengaturan CPU dan GPU yang Tepat
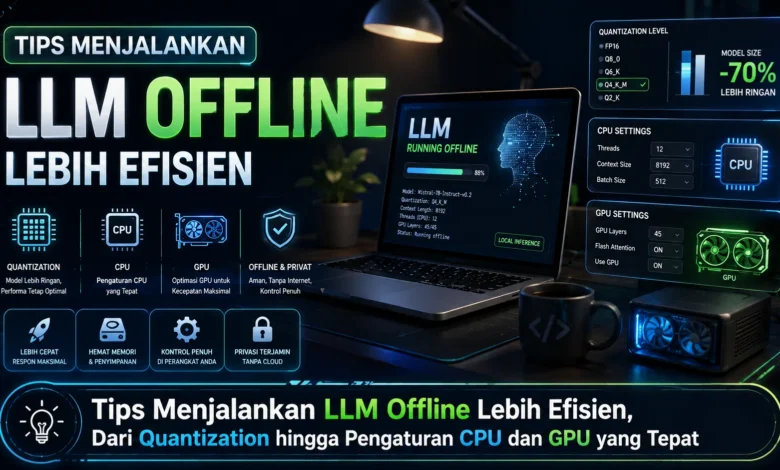
Menjalankan Large Language Model atau LLM secara offline semakin menarik bagi pengguna yang menginginkan kontrol lebih besar terhadap data, privasi, dan lingkungan AI yang digunakan. Tantangannya, model AI dapat membutuhkan RAM, VRAM, serta kemampuan komputasi yang cukup besar apabila konfigurasi tidak disesuaikan dengan perangkat. Pemilihan model, quantization, context window, hingga pembagian beban antara CPU dan GPU menjadi bagian penting agar sistem tetap responsif. Dengan pengaturan yang tepat, TEKNOLOGI AI lokal dapat berjalan lebih efisien bahkan pada laptop atau PC yang tidak menggunakan hardware kelas atas.
Sesuaikan Model AI dengan Kapasitas Hardware yang Tersedia
Tahap awal mengoptimalkan AI offline adalah menyesuaikan LLM dengan kemampuan komputer. LLM berukuran besar biasanya memerlukan RAM dan VRAM lebih banyak. Memaksakan model seperti itu pada perangkat terbatas dapat membuat inferensi menjadi lambat dan meningkatkan kemungkinan proses terhenti.
LLM dengan parameter lebih ringkas dapat menawarkan pengalaman yang lebih efisien untuk chat lokal, pemrosesan teks. Jumlah parameter bukan satu satunya penentu kualitas, karena optimalisasi inferensi juga menentukan efisiensi penggunaan. Melalui pemilihan yang seimbang, TEKNOLOGI LLM offline dapat menggunakan resource secara lebih efisien.
Quantization Membantu Mengurangi Penggunaan RAM dan VRAM
Pengurangan presisi model menjadi pendekatan populer untuk mengurangi kebutuhan memori. Secara sederhana, teknik ini menggunakan representasi numerik dengan presisi lebih rendah, sehingga ukuran model dapat diperkecil. Efisiensi ini membuat TEKNOLOGI AI lokal semakin mudah diakses oleh perangkat konsumen.
Tingkat quantization yang dipilih sebaiknya tidak hanya ditentukan berdasarkan ukuran file. Kompresi parameter yang lebih kuat dapat memberikan penghematan memori lebih besar, tetapi berpotensi mempengaruhi kualitas keluaran. Oleh sebab tersebut, pengguna sebaiknya memilih format berdasarkan penggunaan nyata hingga memperoleh konfigurasi yang sesuai dengan kapasitas perangkat.
Batasi Panjang Konteks Sesuai Kebutuhan Penggunaan
Context window menentukan berapa banyak informasi yang dapat dipertahankan model. Context window berkapasitas tinggi memang berguna untuk dokumen panjang, tetapi juga dapat meningkatkan kebutuhan memori. Untuk komputer dengan VRAM kecil, menggunakan context maksimal sepanjang waktu dapat mengurangi efisiensi.
Dalam penggunaan AI sehari hari, panjang konteks secukupnya sering lebih efisien. Panjang konteks bisa dinaikkan untuk pekerjaan tertentu daripada mengalokasikan memori untuk konteks yang tidak digunakan. Pengaturan seperti ini membantu mengendalikan konsumsi RAM dan VRAM sekaligus menjaga pengalaman TEKNOLOGI AI tetap nyaman.
Pembagian CPU dan GPU Menentukan Efisiensi Inferensi
Kartu grafis dapat memberikan akselerasi yang signifikan apabila software memiliki dukungan akselerasi. Namun, GPU kelas konsumen sering memiliki batas memori tertentu. Ketika seluruh model tidak dapat dimuat ke GPU, pengguna dapat memanfaatkan GPU offloading secara parsial daripada menghabiskan seluruh VRAM.
Besarnya porsi GPU offloading dapat disesuaikan secara bertahap. Jika VRAM masih memiliki ruang, lebih banyak bagian model dapat diproses melalui GPU. Sebaliknya, apabila muncul keterbatasan memori, sistem dapat menggunakan kombinasi CPU serta GPU. Konfigurasi TEKNOLOGI yang proporsional dapat menghasilkan pengalaman inferensi yang lebih nyaman.
Efisiensi LLM Juga Bergantung pada Software dan Kondisi Sistem
Konfigurasi CPU serta GPU bukan satu satunya bagian dari optimasi. Software inferensi juga dapat menentukan bagaimana hardware dimanfaatkan. Software yang teroptimasi dapat memanfaatkan kemampuan CPU dan GPU dengan lebih baik, sehingga inferensi dapat berjalan lebih stabil.
Jumlah aplikasi yang berjalan juga dapat memberikan pengaruh. Browser dengan banyak tab dapat bersaing menggunakan memori dengan LLM. Membebaskan memori sebelum memulai inferensi merupakan langkah sederhana tetapi berguna. Dengan menggabungkan optimasi software dan hardware, TEKNOLOGI AI lokal dapat digunakan tanpa selalu membutuhkan komputer kelas workstation.
Kesimpulan, Optimasi yang Tepat Membuat LLM Offline Lebih Efisien
Menjalankan LLM offline secara efisien membutuhkan keseimbangan antara model dan hardware. Menggunakan model sesuai kebutuhan, quantization, penyesuaian panjang konteks, serta GPU offloading dapat menjaga sistem tetap responsif. Komputer kelas atas bukan satu satunya pilihan selama konfigurasi disesuaikan dengan kemampuan sistem.
Seiring waktu, TEKNOLOGI LLM lokal kemungkinan terus mengalami optimalisasi melalui arsitektur yang semakin hemat resource. Dari pengalaman Anda, optimasi mana yang paling efektif mengurangi penggunaan memori, apakah GPU offloading? Bagikan pengalaman Anda mengenai penggunaan AI offline dan ikuti pembahasan berikutnya untuk memaksimalkan kemampuan perangkat yang tersedia.