Tips Menjalankan LLM Offline Lebih Efisien, Dari Quantization hingga Pengaturan CPU dan GPU yang Tepat
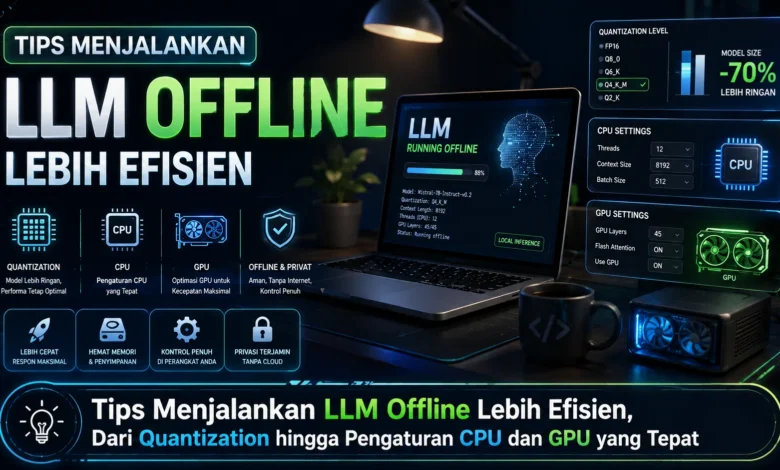
Menjalankan Large Language Model atau LLM secara offline semakin menarik bagi pengguna yang menginginkan kontrol lebih besar terhadap data, privasi, dan lingkungan AI yang digunakan. Tantangannya, model AI dapat membutuhkan RAM, VRAM, serta kemampuan komputasi yang cukup besar apabila konfigurasi tidak disesuaikan dengan perangkat. Pemilihan model, quantization, context window, hingga pembagian beban antara CPU dan GPU menjadi bagian penting agar sistem tetap responsif. Dengan pengaturan yang tepat, TEKNOLOGI AI lokal dapat berjalan lebih efisien bahkan pada laptop atau PC yang tidak menggunakan hardware kelas atas.
Ukuran Model Menjadi Langkah Awal Optimasi AI Offline
Tahap awal mengoptimalkan AI offline adalah menyesuaikan LLM dengan kemampuan komputer. LLM berukuran besar biasanya membutuhkan kapasitas memori yang lebih besar. Menjalankan LLM di luar kapasitas komputer dapat membuat inferensi menjadi lambat dan meningkatkan kemungkinan proses terhenti.
Model AI berukuran moderat dapat menjadi pilihan yang lebih masuk akal untuk bantuan menulis, pemrosesan teks. Jumlah parameter bukan satu satunya penentu kualitas, karena kualitas pelatihan juga mempengaruhi kemampuan yang diberikan. Dengan memilih secara realistis, TEKNOLOGI LLM offline dapat menggunakan resource secara lebih efisien.
Optimalkan Memori dengan Memilih Tingkat Quantization yang Tepat
Pengurangan presisi model menjadi pendekatan populer untuk mengurangi kebutuhan memori. Secara sederhana, teknik ini mengurangi presisi bobot model, sehingga beban penyimpanan menjadi lebih ringan. Penghematan resource tersebut membuat LLM dapat digunakan pada lebih banyak konfigurasi komputer.
Tingkat quantization yang dipilih sebaiknya mempertimbangkan keseimbangan kualitas serta efisiensi. Kompresi parameter yang lebih kuat dapat mengurangi ukuran model secara lebih signifikan, tetapi mungkin mengurangi ketelitian model pada sebagian tugas. Untuk mendapatkan hasil yang seimbang, pengguna sebaiknya membandingkan beberapa tingkat quantization hingga mendapatkan keseimbangan antara kualitas dan kecepatan.
Batasi Panjang Konteks Sesuai Kebutuhan Penggunaan
Context length menentukan berapa banyak informasi yang dapat dipertahankan model. Context window berkapasitas tinggi memang membantu percakapan dengan riwayat besar, tetapi juga dapat menambah beban inferensi. Dalam perangkat dengan kapasitas memori terbatas, menggunakan context maksimal sepanjang waktu dapat menekan resource yang tersedia.
Untuk percakapan sederhana, panjang konteks secukupnya sering lebih efisien. Pengguna dapat meningkatkan batasnya ketika diperlukan daripada langsung menggunakan nilai tertinggi. Pengaturan seperti ini membantu memberikan lebih banyak ruang bagi sistem sekaligus membuat inferensi lokal terasa lebih responsif.
Atur GPU Offloading Sesuai Kapasitas VRAM
GPU dapat memberikan akselerasi yang signifikan apabila software memiliki dukungan akselerasi. Namun, tidak semua komputer memiliki VRAM besar. Ketika seluruh model tidak dapat dimuat ke GPU, pengguna dapat membagi pekerjaan antara CPU dan GPU daripada memaksakan seluruh model berada di GPU.
Besarnya porsi GPU offloading dapat diatur mengikuti kapasitas perangkat. Apabila memori GPU mencukupi, lebih banyak bagian model dapat diproses melalui GPU. Sebaliknya, ketika GPU tidak mampu menampung beban tambahan, sistem dapat menggunakan kombinasi CPU serta GPU. Konfigurasi TEKNOLOGI yang proporsional dapat menghasilkan pengalaman inferensi yang lebih nyaman.
Efisiensi LLM Juga Bergantung pada Software dan Kondisi Sistem
Pemilihan model dan hardware bukan satu satunya bagian dari optimasi. Runtime yang digunakan juga dapat memberikan pilihan konfigurasi yang berbeda. Mesin inferensi yang sesuai dapat memanfaatkan kemampuan CPU dan GPU dengan lebih baik, sehingga resource komputer digunakan secara lebih proporsional.
Penggunaan RAM oleh program lain juga menjadi faktor tambahan. Aplikasi berat di latar belakang dapat bersaing menggunakan memori dengan LLM. Mengurangi proses background merupakan cara praktis meningkatkan ruang tersedia. Dengan menggabungkan optimasi software dan hardware, TEKNOLOGI AI lokal dapat berjalan lebih efisien.
Kesimpulan, LLM Lokal Bisa Berjalan Nyaman dengan Konfigurasi yang Seimbang
Menjalankan LLM offline secara efisien membutuhkan keseimbangan antara model dan hardware. Menentukan LLM secara realistis, pengurangan presisi, pengelolaan jumlah token, serta GPU offloading dapat meningkatkan efisiensi inferensi. Tidak selalu diperlukan hardware termahal selama model dipilih secara proporsional.
Dalam perkembangan berikutnya, TEKNOLOGI LLM lokal kemungkinan terus mengalami optimalisasi melalui arsitektur yang semakin hemat resource. Menurut Anda, optimasi mana yang paling membantu menjalankan AI lokal, apakah GPU offloading? Sampaikan pendapat Anda mengenai konfigurasi LLM lokal dan ikuti inovasi selanjutnya untuk mengetahui teknik optimasi lainnya.