AMD dan Intel Berkolaborasi Mempermudah Pengembangan AI pada Prosesor x86 melalui PyTorch
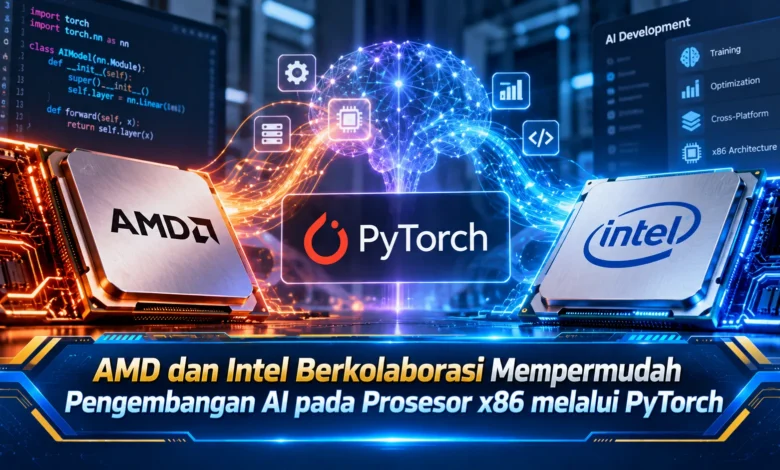
AMD dan Intel mengumumkan kolaborasi teknologi pada 20 Oktober 2026 untuk menyederhanakan pengembangan aplikasi kecerdasan buatan berbasis prosesor x86 menggunakan PyTorch. Kedua perusahaan sepakat menyatukan optimalisasi CPU melalui oneDNN, pustaka perangkat lunak terbuka untuk mempercepat pekerjaan deep learning. Dalam kerja sama tersebut, AMD akan mengintegrasikan teknologi ZenDNN ke dalam oneDNN yang juga digunakan Intel. Langkah ini bertujuan mengurangi perbedaan jalur optimalisasi perangkat lunak antara kedua produsen prosesor. Pengembangan bersama tersebut diharapkan mempermudah programmer membangun, memelihara, dan menjalankan aplikasi AI pada beragam sistem komputer tanpa harus mengandalkan pengaturan khusus untuk setiap merek CPU.
Kerja Sama Dua Produsen CPU Mendukung Pengembangan Kecerdasan Buatan
Kesepakatan kolaborasi antara AMD dan Intel menghadirkan kemajuan menarik dalam pengembangan perangkat lunak AI. Dengan menggabungkan kemampuan kedua perusahaan, AMD dan Intel ingin memperbaiki jalur optimalisasi perangkat lunak. Sebelumnya, kedua perusahaan memiliki teknologi percepatan tersendiri. Perbedaan teknologi ini sering menghadirkan pekerjaan penyesuaian perangkat lunak. Berkat penggunaan sistem optimalisasi terpadu, kedua perusahaan berusaha menghadirkan lingkungan optimalisasi yang konsisten. Melalui strategi tersebut, programmer AI memiliki peluang menggunakan dukungan lintas prosesor.
Penyatuan pengembangan perangkat lunak ini berkaitan dengan rekomendasi x86 Ecosystem Advisory Group. Forum industri ini dibentuk untuk memperkuat ekosistem x86 yang lebih terbuka. Meskipun AMD dan Intel memiliki produk yang saling berkompetisi, kolaborasi untuk ekosistem terbuka mampu menawarkan manfaat bagi pengguna. Pada pengembangan AI saat ini, kemudahan penerapan aplikasi memiliki peran penting. Oleh sebab itu, integrasi pustaka percepatan diharapkan dapat membatasi pekerjaan penyesuaian berulang tanpa membatasi pilihan prosesor pengguna.
oneDNN Menjadi Fondasi Optimalisasi PyTorch pada CPU AMD dan Intel
Teknologi yang menjadi pusat kerja sama adalah oneDNN, yaitu pustaka deep learning terbuka yang dikembangkan untuk percepatan perhitungan jaringan saraf. Sistem optimalisasi ini memiliki komponen percepatan algoritma untuk kebutuhan deep learning. Sebagai contoh, oneDNN berpotensi meningkatkan efisiensi perkalian matriks yang menjadi bagian penting dalam model pembelajaran mendalam. Melalui integrasi PyTorch, pengembang dapat memanfaatkan optimalisasi CPU tanpa mengembangkan semua operasi matematika sendiri. Pendekatan tersebut membantu menyederhanakan proses pengembangan.
Melalui kesepakatan bersama, AMD dan Intel menyepakati oneDNN sebagai fondasi optimalisasi open-source CPU x86 dalam PyTorch. Keputusan tersebut diharapkan menyediakan pengalaman yang lebih konsisten pada berbagai CPU berbasis x86. Ketika aplikasi AI dijalankan pada sistem komputasi x86, sistem pemrosesan tersebut dapat memilih implementasi yang sesuai. Melalui mekanisme tersebut, programmer berpotensi lebih jarang perlu membangun jalur khusus bagi setiap vendor. Namun demikian, efisiensi pemrosesan dapat berbeda menurut jenis prosesor yang digunakan.
Teknologi ZenDNN Mendukung Optimalisasi AI pada Prosesor AMD
Bagian penting dari implementasi adalah penggabungan optimalisasi AMD ke dalam oneDNN. Teknologi optimalisasi milik AMD dirancang membantu percepatan operasi AI pada perangkat keras berbasis AMD Zen. Dalam pengembangan sebelumnya, optimalisasi ZenDNN memiliki jalur pengembangan tersendiri. Dengan memasukkan kemampuan tersebut ke oneDNN, AMD akan mengintegrasikan fungsi percepatan khususnya ke proyek oneDNN. Langkah tersebut diharapkan membantu penyediaan fungsi percepatan yang lebih terpadu. Melalui pendekatan tersebut, pengguna prosesor AMD diharapkan memiliki akses terhadap fungsi percepatan arsitektur Zen melalui ekosistem pustaka bersama.
Tidak hanya menyumbangkan teknologi optimalisasi, AMD turut menjadi bagian sebagai Steering Member dalam UXL Foundation. Yayasan teknologi ini mendukung tata kelola inisiatif akselerasi komputasi, termasuk oneDNN. Keanggotaan AMD memungkinkan partisipasi dalam arah pengembangan proyek. Sementara itu, Intel mempertahankan keterlibatan pada peningkatan dukungan prosesor. Berkat pengembangan bersama, pengembang aplikasi dapat memanfaatkan kemampuan optimalisasi yang lebih konsisten. Meski arah pengembangan sudah disepakati, integrasi seluruh kemampuan tetap membutuhkan pengujian sebelum dapat digunakan secara luas.
AMD dan Intel Menyiapkan Instruksi Baru untuk Mempercepat Operasi AI
Di samping kolaborasi optimalisasi PyTorch, AMD dan Intel turut mengembangkan pada AI Compute Extensions atau ACE. Pengembangan instruksi ini menjadi perluasan arsitektur instruksi x86 yang dirancang mengoptimalkan pemrosesan perkalian matriks. Dalam pengembangan kecerdasan buatan, perkalian matriks merupakan komponen mendasar. Aktivitas tersebut menjadi bagian dari proses inferensi model. Melalui instruksi khusus, perangkat keras x86 kompatibel diharapkan mampu memproses perhitungan AI melalui jalur instruksi khusus.
Kolaborasi pada instruksi baru dirancang terhubung dengan integrasi oneDNN dalam PyTorch. AMD dan Intel menyampaikan bahwa integrasi teknologi tersebut akan dikembangkan melalui rilis perangkat lunak lanjutan. Dengan pendekatan tersebut, pembuat aplikasi machine learning dapat memperoleh akses terhadap fitur percepatan perangkat keras tanpa harus mengubah seluruh kode aplikasi. Meski arah pengembangannya telah dijelaskan, teknologi tersebut bukan bukti adanya fitur universal pada semua CPU saat ini. Pemanfaatan teknologi tersebut harus mempertimbangkan implementasi perangkat keras yang telah disiapkan.
Optimalisasi PyTorch pada CPU x86 Mendukung Infrastruktur Data Center
Nilai tambah penting dari kolaborasi optimalisasi PyTorch adalah penyederhanaan pemeliharaan perangkat lunak pada prosesor AMD dan Intel. Pada kebutuhan pusat data, penggunaan sistem dari beberapa vendor dapat menimbulkan kebutuhan pengujian tambahan. Sebagai contoh, sebuah perusahaan dapat mengoperasikan beberapa kelompok server x86 untuk menjalankan layanan AI. Melalui satu jalur optimalisasi, tim perangkat lunak berpotensi membatasi kebutuhan penyesuaian khusus vendor. Berkat penyatuan ini, pengujian perangkat lunak berpotensi menjadi lebih praktis.
Selain kebutuhan server, dukungan perangkat lunak yang lebih konsisten memiliki manfaat potensial bagi peneliti. Berbagai aplikasi kecerdasan buatan selalu memerlukan akselerator khusus. Pada beban kerja yang sesuai, CPU mampu menjalankan untuk inferensi berdasarkan kapasitas memori. Sebagai ilustrasi, aplikasi klasifikasi sederhana dapat dijalankan pada CPU kompatibel. Melalui optimalisasi oneDNN, bagian pemrosesan model dapat memanfaatkan implementasi yang disesuaikan. Walaupun CPU tetap memiliki peran penting, kebutuhan GPU masih diperlukan untuk banyak pekerjaan, terutama ketika pelatihan berskala besar dilakukan.
Penyatuan Optimalisasi CPU Menjadi Langkah Penting Teknologi Kecerdasan Buatan
Kesepakatan pengembangan AMD dan Intel menunjukkan kemajuan menarik dalam pengembangan perangkat lunak deep learning. Berkat integrasi optimalisasi ZenDNN ke dalam oneDNN, kedua perusahaan berupaya menciptakan jalur perangkat lunak yang lebih konsisten. Pendekatan tersebut berpotensi mempermudah pengembang AI dalam memelihara kode pada prosesor AMD maupun Intel. Tidak hanya itu, rencana dukungan instruksi ACE berpotensi memperluas percepatan operasi matriks. Meski kerja sama memiliki potensi besar, hasil peningkatan performa masih perlu diuji berdasarkan versi perangkat lunak yang digunakan.
Dalam perkembangan TEKNOLOGI, penyederhanaan jalur optimalisasi tetap menjadi prioritas pengembangan untuk memperluas pilihan infrastruktur. Integrasi ZenDNN ke oneDNN dapat menjadi fondasi kerja sama terbuka. Meski demikian, AMD dan Intel masih memiliki produk yang berkompetisi dalam penjualan perangkat keras komputasi. Melalui kondisi tersebut, industri diharapkan mendapatkan kemudahan penerapan aplikasi AI. Hasil pengembangan bersama dapat dievaluasi dari pengujian performa pada rilis perangkat lunak mendatang. Menurut pandangan Anda, apakah penyatuan optimalisasi melalui oneDNN mampu meningkatkan efisiensi pemrosesan CPU? Jangan ragu menyampaikan pandangan mengenai masa depan prosesor x86.