AI Inference Engine Optimization Dorong Era On-Device AI yang Lebih Cepat dan Efisien
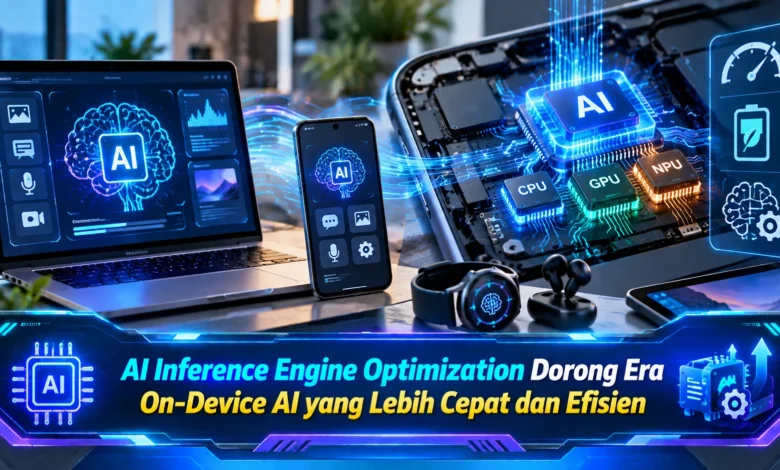
Perkembangan AI mulai bergerak semakin dekat ke perangkat pengguna melalui konsep on device AI. Smartphone, laptop, wearable, kendaraan, dan berbagai perangkat pintar kini membutuhkan kemampuan menjalankan model kecerdasan buatan secara cepat tanpa selalu bergantung pada pemrosesan cloud. AI Inference Engine Optimization menjadi bagian penting dalam perubahan tersebut karena teknologi ini membantu model memanfaatkan CPU, GPU, NPU, memori, dan sumber daya perangkat secara lebih efisien sehingga pengalaman AI lokal dapat terasa semakin responsif.
On Device AI Membutuhkan Inference Engine yang Semakin Efisien
Optimalisasi inference berfokus pada bagaimana model kecerdasan buatan dapat dijalankan dengan penggunaan hardware yang lebih efisien. Model yang sudah dilatih membutuhkan proses inference ketika menerima data baru sebelum dapat menghasilkan prediksi maupun respons. Tahap tersebut dapat melibatkan banyak operasi matematika sehingga kecepatan hardware saja belum tentu cukup apabila alur komputasinya tidak dioptimalkan.
Untuk on device AI, optimalisasi memiliki peran besar sebab perangkat lokal mempunyai batas konsumsi energi, kapasitas memori, temperatur, serta performa hardware. Inference engine dapat menganalisis struktur model, memilih operasi yang sesuai, menentukan penggunaan accelerator, dan mengurangi proses yang tidak diperlukan. Mekanisme ini menunjukkan bahwa teknologi on device AI membutuhkan perpaduan hardware yang memadai dan software yang mampu menggunakan sumber daya secara optimal.
CPU GPU dan NPU Bekerja Bersama Mempercepat AI Lokal
Perangkat modern dapat memiliki beberapa jenis unit pemrosesan dengan karakteristik yang berbeda. CPU dapat menjalankan beragam tugas dengan fleksibel, GPU unggul pada komputasi paralel, sementara NPU menyediakan akselerasi khusus untuk berbagai operasi AI. Kemampuan yang berbeda memungkinkan mesin inference membagi operasi berdasarkan kekuatan masing masing unit pemrosesan.
Penjadwalan pekerjaan yang efisien dapat mencegah seluruh operasi inference bergantung hanya pada satu unit komputasi. Pekerjaan serbaguna dapat menggunakan CPU, operasi paralel dapat diberikan kepada GPU, sedangkan komputasi AI tertentu dapat memanfaatkan NPU. Namun, inference engine juga perlu mempertimbangkan biaya perpindahan data antara unit pemrosesan karena pembagian yang terlalu sering dapat menghasilkan overhead tambahan. Dengan penjadwalan yang tepat, teknologi on device AI dapat memanfaatkan kombinasi hardware secara lebih seimbang untuk meningkatkan performa sekaligus menjaga penggunaan daya.
Operator Fusion Membuat Proses AI Lokal Lebih Efisien
Model kecerdasan buatan dapat terdiri dari sejumlah operasi matematika yang saling berhubungan dalam sebuah graph komputasi. Inference engine dapat menganalisis struktur tersebut untuk mencari bagian yang dapat disederhanakan, digabungkan, atau dieksekusi dengan metode yang lebih efisien. Langkah ini dilakukan untuk menekan proses tambahan tanpa menghilangkan fungsi yang diperlukan oleh model.
Operator fusion dapat digunakan untuk menggabungkan beberapa tahap komputasi sehingga eksekusinya tidak harus dilakukan secara terpisah. Penggabungan operasi dapat menekan frekuensi transfer data sehingga prosesor tidak perlu terlalu sering mengakses memori. Ketika overhead dan perpindahan data dapat dikurangi, CPU, GPU, maupun NPU dapat menggunakan lebih banyak waktu untuk menjalankan komputasi utama. Pendekatan tersebut membuat teknologi AI lokal dapat memperoleh peningkatan efisiensi tanpa harus terus mengandalkan hardware yang semakin kuat.
Presisi Numerik Membantu Mengurangi Beban On Device AI
Salah satu pendekatan penting dalam optimalisasi inference adalah quantization karena model kecerdasan buatan memproses sejumlah besar nilai numerik. Penggunaan presisi yang lebih rendah pada operasi yang sesuai dapat membantu menekan konsumsi memori dan kebutuhan pemrosesan. Format data yang lebih kecil dapat membantu mengurangi kebutuhan bandwidth karena parameter dapat dipindahkan secara lebih efisien.
Keuntungan quantization dapat meningkat apabila hardware menyediakan akselerasi untuk presisi numerik tertentu. Namun, pengurangan presisi tetap perlu dievaluasi karena konfigurasi yang terlalu agresif dapat memengaruhi kualitas keluaran model. Sistem inference harus mempertimbangkan performa, kapasitas penyimpanan, kebutuhan RAM, efisiensi daya, dan kualitas keluaran secara bersamaan. Keseimbangan tersebut sangat penting bagi teknologi on device AI karena perangkat lokal perlu memberikan respons cepat tanpa menguras baterai secara berlebihan.
AI Lokal Membutuhkan Keseimbangan Performa dan Konsumsi Energi
Kecepatan prosesor bukan satu satunya faktor yang menentukan performa on device AI karena aliran data antara memori dan unit komputasi juga memiliki peran besar. Unit pemrosesan yang cepat tetap dapat kehilangan efisiensi ketika harus menunggu data maupun parameter tersedia. Karena itu, inference engine dapat mengoptimalkan penggunaan buffer, alokasi memori, urutan operasi, serta penggunaan kembali ruang penyimpanan sementara.
Penggunaan energi menjadi faktor penting sebab workload AI yang berjalan dalam waktu lama dapat meningkatkan konsumsi baterai dan temperatur. Sistem dapat memilih unit pemrosesan berdasarkan kebutuhan serta mengelola workload agar hardware tidak bekerja terlalu berat untuk tugas yang sebenarnya ringan. Cara tersebut membantu teknologi AI lokal diterapkan pada ponsel, komputer portabel, wearable, serta perangkat pintar yang membutuhkan keseimbangan performa dan efisiensi energi.
Kesimpulan
Perkembangan on device AI semakin bergantung pada AI Inference Engine Optimization karena proses kecerdasan buatan perlu dilakukan secara cepat sekaligus efisien pada perangkat lokal. Pengelolaan workload di antara CPU, GPU, serta NPU membantu meningkatkan pemanfaatan hardware, sedangkan graph optimization dan operator fusion membuat proses komputasi lebih ringkas. Quantization membantu menekan ukuran serta kebutuhan komputasi model, sementara optimalisasi memori mengurangi hambatan dalam perpindahan informasi. Ketika seluruh teknik tersebut dipadukan dengan pengelolaan konsumsi daya, teknologi AI lokal dapat menghasilkan pengalaman yang lebih cepat, responsif, dan efisien. Optimalisasi yang semakin baik dapat membuat lebih banyak fitur AI dijalankan pada perangkat sehingga pemrosesan cloud tidak selalu diperlukan untuk setiap tugas. Pembaca dapat terus mengikuti perkembangan AI Inference Engine Optimization dan berbagi pandangan mengenai fitur on device AI yang paling menarik untuk hadir pada smartphone, laptop, maupun perangkat pintar generasi berikutnya.